На итоговом звонке курса один из студентов поблагодарил меня не за лекции и не за домашки. За ревью логов: «Это то, о чём я сам бы не подумал, а это очень хороший инструмент». В этот момент я понял, что случайный эксперимент с проверкой процесса дорос до продукта. Сейчас расскажу, как жалоба студентов первого потока превратилась в open source плагин RetroPair, который я на этой неделе выложил на GitHub.
С чего началось: «домашки решаются в один промпт»
Первый поток курса AI-Driven Development я закончил с неприятным осадком и писал об этом разбор. Студенты независимо друг от друга сказали одно и то же: домашние задания расписаны так подробно, что решаются в один промпт в цикле. Получаешь ответ, сдаёшь, идёшь дальше. Получалось, что я проверял результат, а учились ребята не тому, что было нужно.
Тогда же я сформулировал главный вывод первого потока: проблемы разработчиков с AI - это не проблемы инструмента. Это отсутствие собственной системы работы. Кодинг занимает 20-30% времени, всё остальное - постановка задачи, планирование, проверка результата, решение, что делегировать агенту, а что оставить себе. Вот эти 70-80% никто не тренирует: в готовом коде остаётся только результат, а путь к нему - за кадром.
А где видно? В логах сессий. Claude Code, Codex, Cursor - все пишут транскрипты диалогов человека и агента. Это готовый материал: как человек ставит задачу, как реагирует на ошибки, проверяет ли результат или принимает на слово, откатывается ли после неудачной попытки. Я решил: во втором потоке буду проверять не только домашки, но и процесс.
Как проверить сотни сессий
Со второго потока студенты сдавали домашки вместе с логами своих кодинговых агентов: Claude Code, Codex, Cursor. Два параллельных потока, Level 1 и Level 2. Масштаб быстро стал ощутимым: у одной студентки за курс набралось больше пятисот логов, у другого - пятьдесят одна сессия за один финальный модуль. Вручную это не читается, да и не должно.
Процесс рождался постепенно, по ходу курса. Сначала были простые скиллы: собрать логи, отфильтровать мусор, найти в репозитории студента нужные файлы. Потом появилась санитизация - из логов вычищаются ключи, токены и персональные данные до того, как их увидит любой агент. Дальше - двухступенчатая оценка: агенты-коллекторы читают сессии пачками и приносят дословные цитаты с адресами, а отдельный агент-судья оценивает работу по восьми критериям. Каждый вердикт стоит на цитате из лога, без цитаты балл не ставится. В конце цепочки - критик, который настроен как опытный разработчик-адресат: он читает черновик фидбэка и решает, применил бы ты его завтра или выкинул.
Зачем нужна эта оценка. Она описывает не код агента, а процесс человека: насколько осознанно он ставит задачу, проверяет результат, дозирует доверие и оставляет себе пути отхода. Шкала по каждому критерию - от 0 до 4 с описанными якорями, чтобы «тройка» означала одно и то же у разных людей и на разных модулях. Сами критерии:
- Постановка задачи. Насколько явно человек задаёт контекст, границы и критерий готовности до того, как агент начал работать.
- Проверка результата. Принимается ли ответ агента на веру или сверяется с наблюдаемым прогоном и собственными критериями.
- Мера доверия агенту. Различается ли, что можно делегировать целиком, а где нужен свой порог приёмки и контроль.
- Работа с контекстом. Как управляется окно агента: что подать на вход, что зафиксировать файлом, когда открыть свежую сессию.
- Разбиение работы. Режется ли задача на шаги с точками проверки или отдаётся агенту одним куском.
- Решения за собой. Остаётся ли за человеком выбор из равных вариантов или молча принимаются рекомендации агента.
- Смена подхода после неудачи. Меняется ли рычаг после повторной неудачи, а не повторяется то же действие в надежде на другое поведение.
- Возможность отката. Есть ли точки возврата: коммиты, ветки, изоляция экспериментов до рискованных прогонов.
Смысл не в балле за один срез, а в динамике: видно, что человек тренирует и что проседает.
Отдельная механика - рекомендации. После каждого ревью студенту давались конкретные советы, а на следующем модуле агенты проверяли, применил он их или нет, и выставляли вердикт: услышал, частично, не видно. Получалась не разовая оценка, а траектория.
Итог по двум потокам: 26 человек получили персональные HTML-отчёты - своя динамика по осям, все тексты ревью, история рекомендаций. Сто с лишним прогонов оценки, сотни разобранных сессий.
Как это выглядит на живом примере. На одном из ревью судья нашёл паттерн: агент два раза прямо спросил студента, что делать с найденными ключами в коде, и предупредил, что это стоит решить до публикации ветки. Человек в этих местах отвечал о другом, а ветку опубликовал - с висящим вопросом. Ревью выдало рекомендацию: явный вопрос агента и любое его «это стоит решить до» закрывать отдельной репликой до публикации - решением либо названной причиной оставить как есть. Через модуль та же проверка смотрела новые сессии уже с этим вопросом: услышал или нет. Так работает петля, которой нет ни в одном статическом анализаторе: совет не улетает в воздух, а проверяется на следующем цикле.
Что сказали студенты
На итоговых собраниях обоих потоков ревью логов назвали одной из самых полезных частей курса. Причём полезной она оказалась даже для тех, кто уже около двух лет работает с кодинговыми агентами: инсайтов, о которых не думаешь в процессе работы, нашлось много и у них. Цитирую по памяти, без имён.
Техлид: «Очень понравился сбор моих сессий. Это то, о чём я сам не подумал. Было очень интересно посмотреть, как я использую AI со стороны, с оценкой».
Разработчик, которая получила три таких ревью: «Полезнее всего - список ошибок в начале отчёта и рекомендации, что делать, когда агент зациклился. Я старалась вспоминать, в чём были мои проблемы, и исследовать их».
Другой студент - про личный отчёт: «Когда читаешь и понимаешь, на что обращать внимание и где лучше работать - теперь это не чёрный ящик».
А самый показательный комментарий от инженера, который строит собственный конвейер разработки с ревьюерами, критиками и кодерами: он сказал, что хочет встроить этот инструмент в свой пайплайн - чтобы агенты ревьюили работу агентов на постоянной основе. И техлид на втором итоговом увидел в групповом отчёте радарную диаграмму по восьми осям и предложил масштабировать это с учебной группы на целую компанию: оценивать, как команды реально осваивают работу с AI, а не отчитываться о количестве установленных лицензий.
Плагин RetroPair
К концу курса у меня накопился работающий процесс: скиллы, агенты, скрипты, санитайзер, HTML-отчёты. Всё это существовало в виде самодельных обвязок под структуру студенческих репозиториев. Я упаковал его в плагин RetroPair для Claude Code.
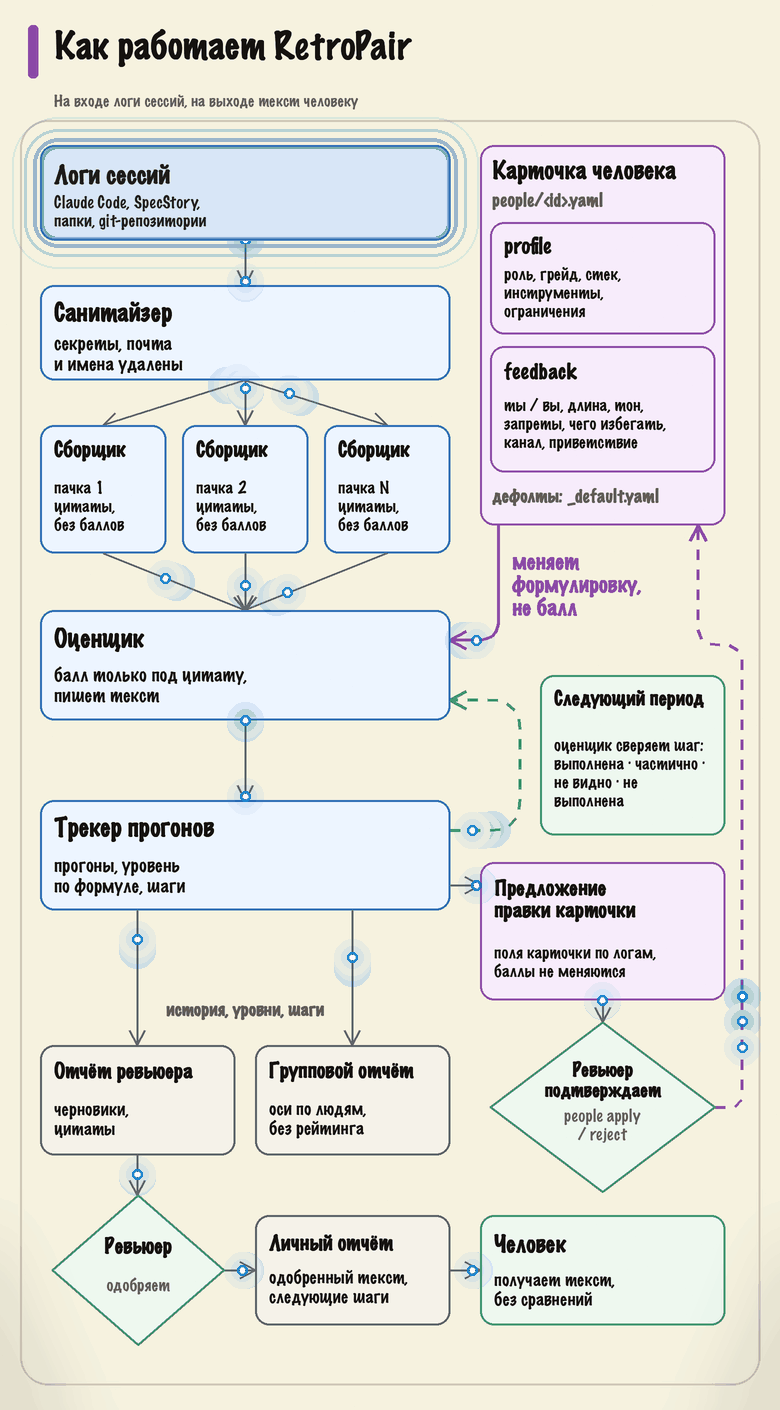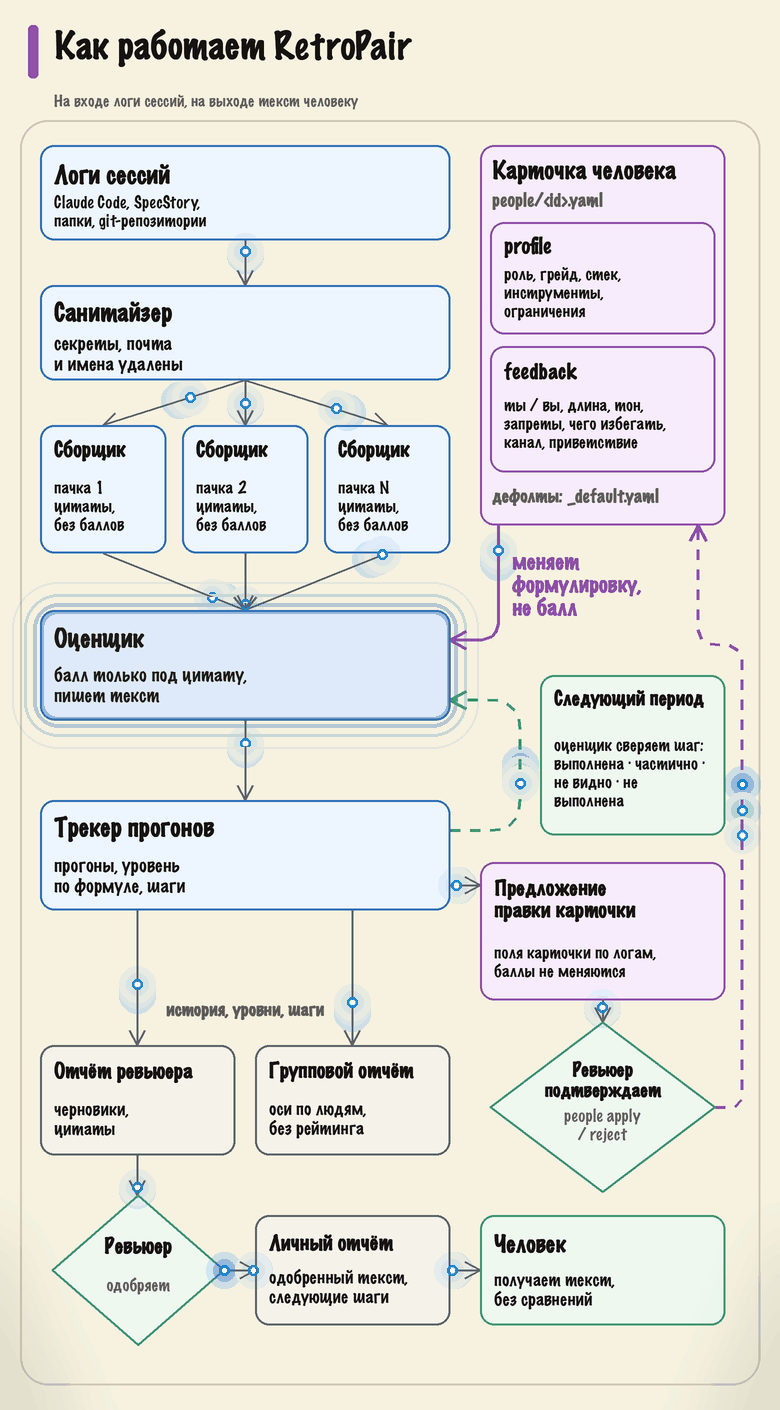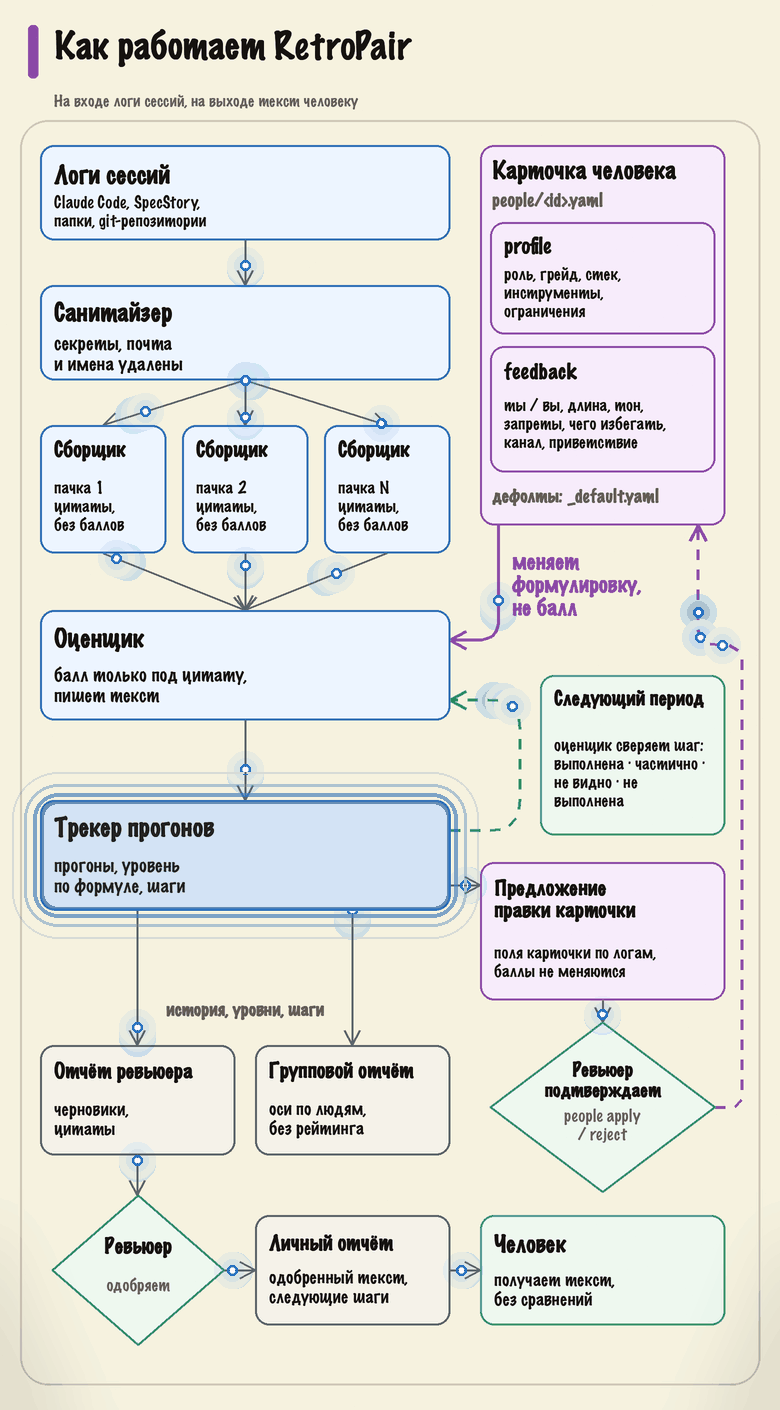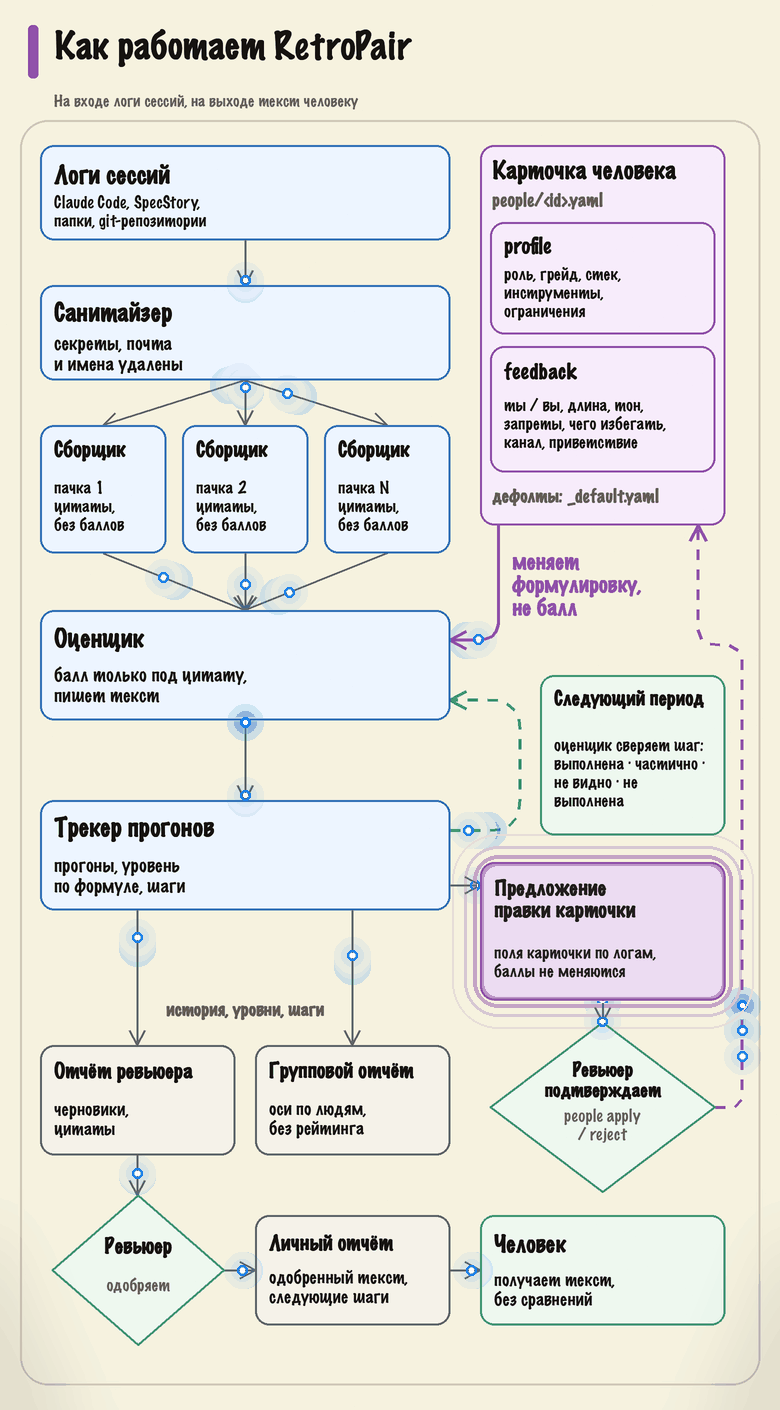
Что он делает:
| Возможность | Что получаете |
|---|---|
| Сбор и санитизация логов | Логи собираются локально, ключи и персональные данные вычищаются до анализа |
| Двухступенчатая оценка | Коллекторы приносят цитаты, судья ставит восемь баллов со ссылкой на доказательства |
| Рекомендации с трекингом | Советы не забываются: следующее ревью проверяет, применили ли вы их |
| Три вида отчётов | Личный - себе, групповой - команде с динамикой по осям, ревьюерский - тому, кто проверяет |
| Приватность | Всё работает локально, логи никуда не отправляются |
Плагин анализирует сессионные логи из любой среды - сам разбор не привязан к IDE, я проверял на Claude Code, в Codex обещает работать, но там ещё буду тестировать. Забрать можно здесь: https://github.com/Serg1kk/retropair, сайт с демо - https://www.retropair.dev
Что понял
Я строил этот инструмент для себя: закрыть собственную боль преподавателя, который должен разобрать сотни сессий и не утонуть. Классический build for yourself. Но получился продукт не только для себя - потому что боль оказалась общей. Тимлид, который хочет понять, как его команда на самом деле работает с агентами. Инженер, который хочет расти и видеть свою динамику. Компания, которая внедряет AI и не может отличить реальное использование от галочки в отчёте.
Второй вывод - про выбор, который встаёт после любого такого проекта. Инструмент работает, фидбэк хороший, и у тебя два пути: пусть лежит на полке и пылится, или отдать комьюнити. Я выбрал второе, в том числе чтобы наконец разобраться, как живётся в open source. Шучу, что мой проект станет популярным на десять звёзд. Ну, или на одиннадцать.
Попробуйте, если ведёте команду или просто хотите посмотреть на свою работу с агентом со стороны. Фидбэк приветствуется - я продолжаю допиливать.
И напоследок личное. Для меня это был последний поток в преподавании на неопределённое время: два курса съедали время и энергию, которых не хватает на основные проекты. Курсы продолжаются: Level 1 и Level 2 теперь ведут два других крутых преподавателя. Спасибо всем студентам обоих потоков: вы два месяца сдавали свои логи и честно отвечали на вопросы, а получили инструмент, которым теперь можно пользоваться бесплатно.
Частые вопросы
Куда уходят мои логи?
Никуда. Плагин работает локально: логи собираются и анализируются на вашей машине, в вашем Claude Code. Санитайзер вычищает ключи и персональные данные до того, как файлы вообще попадают в анализ. Сегодня это осознанный принцип: реальные сессии разработки - слишком чувствительный материал, чтобы выгружать их на чужой сервер.
Работает ли без Claude Code?
Разбор логов не привязан к IDE: плагин понимает сессионные логи из разных сред, включая выгрузки SpecStory и экспорты скроллбека терминала. Сам плагин ставится в Claude Code; в Codex должен работать тоже, но там я его ещё не тестировал - допиливаю.
Чем это отличается от простого чтения своих логов?
Тем, что вы не читаете, а получаете разбор с доказательной базой: оценка по каждой оси стоит на дословной цитате с указанием сессии и хода. Плюс динамика: одно ревью - это снимок, несколько ревью подряд - траектория, по которой видно, растёт ли постановка задач и появилась ли привычка проверять результат. И рекомендации с вердиктами: следующий прогон проверяет, применили ли вы прошлый совет.
Можно ли применить это на команду?
Да, для этого и групповой отчёт: таблица «люди × восемь осей», распределения и динамика группы по периодам. Периоды вы назначаете сами - неделя, месяц, спринт. На итоговом звонке курса техлид увидел в этом готовый инструмент оценки того, как команда реально осваивает работу с агентами, вместо отчётов по лицензиям.